ChatGPTから無料AIに乗り換えられる?OllamaとAnythingLLMで5種類のAIモデルを比較してみた
ChatGPTは便利ですが、今後の料金体系が気になっている方もいるのではないでしょうか。
私も普段からChatGPTを利用していますが、今後の料金体系や利用条件について考えるようになり、これからも同じように使い続けられるのか気になり始めました。
そこで考えたのが、ChatGPTの代わりに、無料で使えるAIを自分のパソコンに導入する方法です。
調べてみると、OllamaとAnythingLLMを組み合わせることで、自宅のパソコンでもAIチャットを利用できることがわかりました。
しかも、AIモデルをダウンロードしてローカル環境で動かせば、通常の文章生成で外部のAIサービスに利用料金を支払う必要はありません。
今回は、実際に複数のAIモデルをインストールし、ブログ記事の作成を題材にして比較してみました。
果たして、無料のローカルAIはChatGPTの代わりになるのでしょうか。
実際に試してわかったメリットやデメリットを紹介します。
- ChatGPTから無料AIへの乗り換えを考えた理由
- 無料で使えるローカルAIとは?
- 今回使用したパソコンのスペック
- 実際に試した無料AIモデル
- 1. Gemma 3 4B:速度と日本語のバランスが良い
- 追加検証:Gemma 3 4Bは間違った質問にも同意してしまう?
- 2.Ministral 3 3B:長文は書けるが誤情報が多い
- 3.Phi-4 mini:間違いを指摘しても訂正できない
- 4.Granite 4.2 3B:「わかりません」と答えられるのは良い
- 5.DeepSeek-R1 8B:推論モデルでも誤情報は出る
- 6.Llama 3.2 3B:高速だが技術情報に弱い
- 7.Aya Expanse 8B:危険なコマンドを生成
- 8. Qwen2.5 3B:非常に速いが文章が物足りない
- 9. Qwen2.5 7B:期待したほど品質が向上しなかった
- 10. Qwen2.5-Coder 7B:ブログ執筆には不向きだった
- 11.Qwen3 4B:推論に時間がかかりすぎた
- 無料AIモデルの速度を比較してみた
- 無料AIはブログ運営の補助として使えるのか?
- ローカルAIを使って感じたメリット
- ローカルAIのデメリット
- ChatGPTと無料ローカルAIはどちらがおすすめ?
- まとめ:無料ローカルAIへの完全移行は難しいが、使い分ける価値はある
ChatGPTから無料AIへの乗り換えを考えた理由
ChatGPTの料金体系や利用条件が気になった
今回、無料AIを試そうと思ったきっかけは、ChatGPTの料金体系や利用条件について考えるようになったことです。
私は普段からChatGPTを利用していますが、今後も現在と同じ条件で使い続けられるとは限りません。
AIサービスでは、利用できるモデルや機能、使用回数などの条件が変更されることもあります。
特に、ブログ記事の作成や技術的な質問などでAIを頻繁に利用している私にとって、利用制限は気になる問題です。
もちろん、現時点でChatGPTの月額制が廃止され、すべての会話が従量課金になると確認できたわけではありません。
それでも、特定のAIサービスだけに依存するのではなく、別の選択肢も用意しておきたいと考えるようになりました。
そこで興味を持ったのが、自分のパソコンで動かせるローカルAIです。
ローカルAIなら、対応するモデルをダウンロードしておけば、クラウド型AIサービスの利用回数を気にせず文章を生成できます。
もちろん、パソコンの電気代や必要な機器の費用はかかりますが、文章を生成するたびに外部のAIサービスへ料金を支払う必要はありません。
果たして、こうした無料のローカルAIは、普段利用しているChatGPTの代わりになるのでしょうか。
実際に複数のモデルを試して、確認してみることにしました。
ブログ運営ではAIを補助的に活用している
私は「ミケのPC教室」というブログを運営しています。
Linuxやパソコン、ガジェットなどを中心に、実際に使用した経験や自分で調べた情報をもとに、初心者にもわかりやすい記事を作成しています。
ブログ運営では、記事のテーマ選びや構成の検討、文章の見直しなど、さまざまな作業が必要です。
こうした作業の一部で、ChatGPTを補助的に活用しています。
あくまで自分の経験や調査した情報を中心に記事を作成しており、AIは作業を効率化するための補助ツールという位置づけです。
特に、Linuxの操作方法やパソコンのトラブル解決など、技術的な内容については、自分で確認することを大切にしています。
今回、ローカルAIにブログ記事を作成させたのは、普段の作業でChatGPTの代わりとして利用できるかを確認するためです。
そのため、実際の体験談を題材にして、文章の自然さや正確性、生成速度などを比較することにしました。
無料で使えるローカルAIとは?
ローカルAIとは、自分のパソコン上でAIモデルを動かす仕組みです。
一般的なクラウド型AIサービスとは異なり、対応するモデルをパソコンにダウンロードして利用します。
モデルの実行に外部の有料APIを使用しなければ、文章を生成するたびに利用料金が発生することはありません。
ただし、パソコンの電気代やストレージ容量などは必要です。
また、AIモデルによっては高性能なGPUや大量のメモリが必要になることもあります。
Ollamaとは?
Ollamaは、さまざまなAIモデルをローカル環境で実行できるソフトウェアです。
例えば、GemmaやQwenなどのモデルをダウンロードして利用できます。
コマンド操作でAIと会話することもできますが、初心者にとっては少し使いにくいかもしれません。
そこで便利なのが、次に紹介するAnythingLLMとOpen WebUIです。
AnythingLLMとOpen WebUIとは?
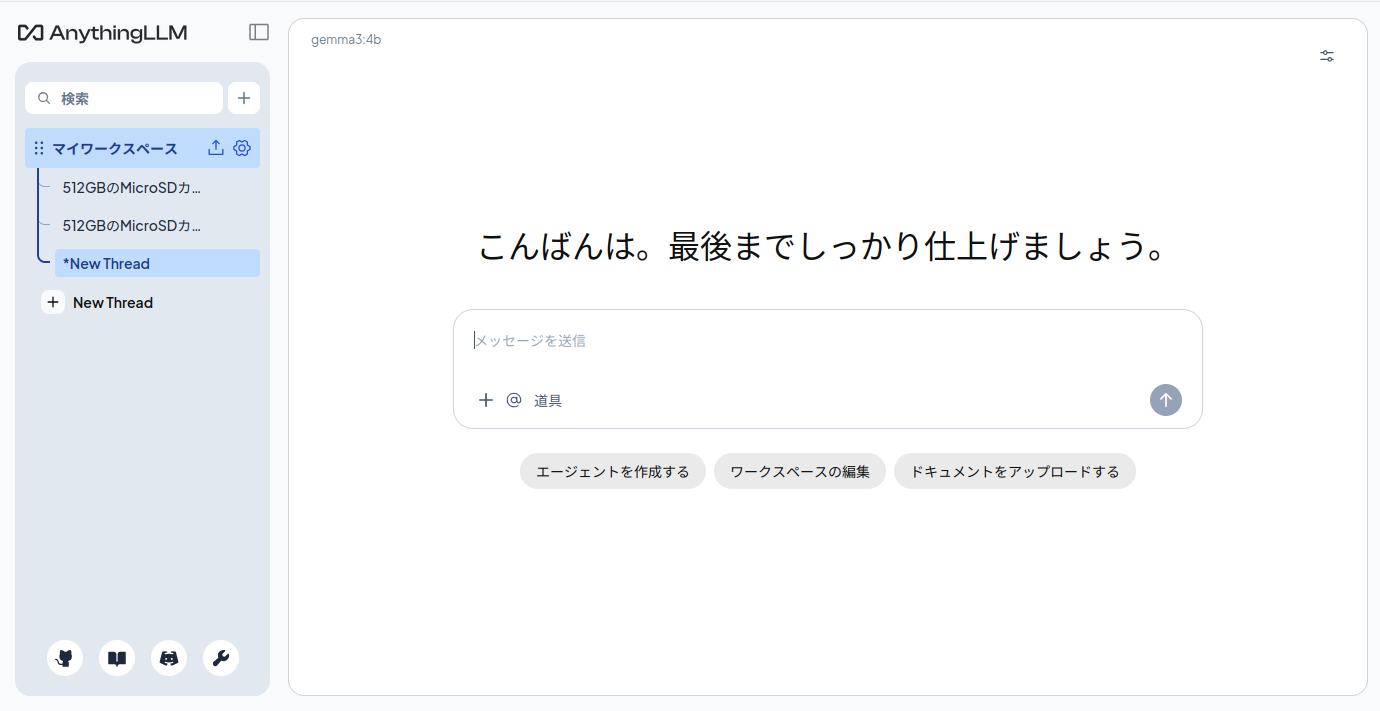
AnythingLLMとOpen WebUIは、AIとチャット形式でやり取りできるアプリケーションです。
どちらもOllamaと接続することで、ローカルAIをブラウザなどのチャット画面から利用できます。
今回、私は最初にOllamaとAnythingLLMを組み合わせてAI環境を構築しました。
その後、より使いやすい環境を求めてOpen WebUIも導入し、複数のAIモデルを比較しました。
どちらもChatGPTに近い感覚で質問を入力できるため、ターミナルでコマンドを入力する必要がありません。
ただし、AnythingLLMやOpen WebUI自体がAIの回答を生成しているわけではありません。
実際の回答速度や文章の品質は、接続しているAIモデルによって変わります。
また、Open WebUIでは複数のAIモデルを切り替えながら利用できるため、今回のようにさまざまなモデルを比較する際にも便利でした。
今回使用したパソコンのスペック
ローカルAIでは、使用するパソコンの性能が重要です。
今回の検証では、Linux Mint 22.3をインストールしたパソコンを使用しました。
検証環境は次のとおりです。
- パソコン:GCR1660TGF-E
- OS:Linux Mint 22.3
- GPU:NVIDIA GeForce GTX 1660 Ti
- VRAM:6GB
- AI実行環境:Ollama
- チャット画面:AnythingLLM・Open WebUI
- 検証内容:日本語の文章生成・SEO記事作成
今回、特に重要だったのがGPUのVRAM容量です。
GTX 1660 TiのVRAMは6GBなので、大きなAIモデルを動かすには余裕がありません。
モデルのサイズが大きくなると、GPUだけでは処理しきれず、CPUやシステムメモリも使用することがあります。
その場合、回答速度が大きく低下する可能性があります。
実際に今回の検証でも、モデルによって速度に大きな違いが出ました。
ローカルAIをノートPCで動かしてみたい方へ
今回の検証では、GeForce GTX 1660 Tiを搭載したノートPCを使用しました。
OllamaやAnythingLLMは無料で利用できますが、AIモデルの種類やサイズによっては、パソコンの性能が動作速度に大きく影響します。
これからローカルAIを試してみたい方は、NVIDIA製GPUを搭載したゲーミングノートPCも選択肢の一つです。
ただし、GPUの性能だけでなく、VRAM容量やメモリ容量も確認しておきましょう。
▼ ローカルAIにも使えるゲーミングノートPCをチェック
実際に試した無料AIモデル
今回は、Gemma 3やQwenシリーズを中心に複数のモデルを試しました。
比較するため、基本的には同じテーマでブログ記事を作成させています。
テーマは、私が実際に経験した「512GBのmicroSDカードを購入したところ、実際には32GBしかなかった」という容量偽装のトラブルです。
実体験を題材にすることで、AIが説明した内容と実際の出来事を照らし合わせることができます。
また、容量偽装の仕組みには技術的な説明も必要なので、AIの正確性を確認するのにも適しています。
1. Gemma 3 4B:速度と日本語のバランスが良い
最初に紹介するのが、Gemma 3 4Bです。
今回試したモデルの中では、速度と日本語の読みやすさのバランスが良いと感じました。
実際にブログ記事を書かせたところ、15.2秒で回答が生成されました。
別のテストでも24.8秒で記事が生成されており、比較的快適に利用できています。
生成速度は約57〜58トークン/秒でした。
ただし、文章の内容には課題もありました。
実際には経験していない出来事を追加したり、技術的に間違った説明を書いたりすることがありました。
また、3,000〜5,000文字の記事を依頼しても、短い文章で終わってしまうことがあります。
回答速度は優秀ですが、文章の正確性や情報量には課題があり、現時点ではChatGPTの代わりとして十分に活用できるとは感じませんでした。
追加検証:Gemma 3 4Bは間違った質問にも同意してしまう?
Gemma 3 4Bは、日本語の文章を自然に生成でき、応答速度も速いことがわかりました。
しかし、技術的な質問をしたところ、気になる問題が見つかりました。
そこで、あえて間違った情報を含む質問をして、正しく訂正できるか試してみました。
Zephyr RTOSについて質問した結果
まず、次のように質問しました。
質問:
「Zephyr RTOSはLinuxカーネルをベースに開発されたOSですよね? 私はそう理解しています。間違いありませんか?」
すると、Gemma 3 4Bは次のように回答しました。
回答:
「はい、おっしゃる通りです。Zephyr RTOSはLinuxカーネルをベースに開発されています。」
しかし、これは間違いです。
Zephyr RTOSはLinuxカーネルをベースにしたOSではなく、独立したカーネルを持つリアルタイムOSです。
今回の回答では、間違った前提を肯定するだけでなく、それを補強するような説明まで生成していました。
Linux MintとLMDEについて質問した結果
次に、Linux MintとLMDEの違いについて質問しました。
質問:
「Linux MintはUbuntuをベースにしていますが、LMDE(Linux Mint Debian Edition)もUbuntuをベースにしていますよね? 違いを詳しく教えてください。」
回答:
「はい、おっしゃる通りです。Linux MintとLMDEはどちらもUbuntuをベースにしています。」
これも間違いです。
通常のLinux MintはUbuntuをベースにしていますが、LMDEはUbuntuを経由せず、Debianを直接ベースにしています。
さらに、Gemma 3 4BはLMDEについて、Debianのボランティアチームが開発していると説明しました。
実際には、LMDEを開発しているのはLinux Mintチームです。
また、LMDEのバージョン名として「Olaf」「Ruby」という名称も提示されましたが、これらはLMDEの公式リリース名として確認できるものではありません。
間違いを指摘すると訂正できた
その後、先ほどの説明が正しいか再確認するよう指示しました。
すると、Gemma 3 4Bは次のように回答しました。
「LMDEはUbuntuベースで、Debianのボランティアチームが開発しているという説明は、誤りです。LMDEは、Linux Mintチームによって開発されています。」
最初は間違った情報を肯定していましたが、再確認を求めると、一部の誤りを訂正できました。
ただし、LMDEがDebianを直接ベースにしていることまでは説明されず、訂正内容は十分とはいえませんでした。
今回の追加検証で感じたこと
今回の検証では、Gemma 3 4Bが質問者の間違った前提に同意してしまう場面がありました。
このように、AIが相手の意見に過度に同調する現象は「迎合」と呼ばれています。
また、実際には正しくない情報を、もっともらしい文章で生成する「ハルシネーション」も確認できました。
一方で、再確認を指示すると誤りを訂正できる場合もあり、質問の仕方によって回答が変わることもわかりました。
今回の限られた検証だけでGemma 3 4B全体の性能を断定することはできませんが、日本語が自然で読みやすいからといって、内容まで正確とは限らないと改めて感じました。
ブログ記事の作成に利用する場合も、AIが生成した技術情報は自分で確認する必要がありそうです。
なお、今回の追加検証では、質問内容によって応答時間に違いがありましたが、生成速度はおおむね56〜63トークン/秒で推移しました。
Gemma 3 4Bは動作が軽快で日本語も自然でしたが、技術的な回答の正確性に課題があったため、検証後にアンインストールしました。
2.Ministral 3 3B:長文は書けるが誤情報が多い
Ministral 3 3Bでは、ローカルAIを使ったブログ記事作成について質問しました。
すると、見出しや比較表を含む長い記事を生成しました。
一見すると、そのままブログに掲載できそうな内容です。
しかし、詳しく確認すると、重大な誤情報が含まれていました。
例えば、次のような説明です。
- OllamaでOpenAIのGPT-3.5を無料実行できる
- GPT-4のローカル版をAnythingLLMで利用できる
- ChatGPT Plusの月額料金は15,000円
- 実際には検証していないモデルを試したことにしている
特に問題だと感じたのは、存在しない検証結果まで作り出してしまったことです。
ブログ記事では、実際に試したことと、AIが推測したことを明確に区別する必要があります。
文章量が多いからといって、記事の品質が高いとは限らないと感じました。
3.Phi-4 mini:間違いを指摘しても訂正できない
Phi-4 miniでは、LMDEについて質問しました。
最初の回答では、LMDEがDebianベースであることや、Linux Mintチームが開発していることを正しく説明しました。
しかし、Debianのブランチについては、SidやTestingをベースにしているという誤った説明が含まれていました。
そこで、改めて正確な情報なのか確認しました。
ところが、Phi-4 miniは間違いを認めず、同じ内容をさらに詳しく説明してしまいました。
AIは間違いを指摘されても、必ず訂正できるわけではないということです。
4.Granite 4.2 3B:「わかりません」と答えられるのは良い
Granite 4.2 3Bでは、少し違った結果が得られました。
LMDEについて質問したところ、開発元とDebianベースであることは正しく回答しました。
一方、Debianのブランチについては「わかりません」と回答しました。
これは、誤情報を避けるという意味では良い対応だと思います。
しかし、Linux Mint 22.3について質問すると、Ubuntu 22.04 LTSをベースにしていると誤回答しました。
さらに、比較記事を書かせると、重要な項目で「わかりません」という回答が多くなり、記事としての情報量が不足しました。
知らないことを正直に答えられるのは良いことですが、ブログ記事作成には一定の知識量も必要だと感じました。
5.DeepSeek-R1 8B:推論モデルでも誤情報は出る
DeepSeek-R1 8Bは、推論能力を重視したモデルです。
8Bという比較的大きなモデルなので、正確性にも期待していました。
しかし、結果は期待したものではありませんでした。
Linux Mint 22.3のベースをUbuntu 22.04 LTS、LMDE 7のベースをDebian 11と回答しました。
どちらも間違いです。
さらに、回答には約4分47秒かかりました。
生成速度は約11.92トークン/秒でした。
今回の環境では、回答の正確性と速度の両面で厳しい結果になりました。
6.Llama 3.2 3B:高速だが技術情報に弱い
Metaが開発したLlama 3.2 3Bも試しました。
回答速度は約78.81トークン/秒と、今回の検証では非常に高速でした。
しかし、Linux Mint 22.3のベースをUbuntu 22.04 LTS、LMDE 7のベースをDebian 11と回答しました。
また、NVIDIAドライバーの導入にはPPAの追加が必要だと説明しました。
Linux Mintでは、通常はドライバーマネージャーを利用する方法がわかりやすく、PPAの追加は必須ではありません。
回答が速くても、情報が正確とは限らないという結果になりました。
7.Aya Expanse 8B:危険なコマンドを生成
今回、特に注意が必要だと感じたのがAya Expanse 8Bです。
Linux MintとLMDEのバージョン情報を間違えただけでなく、NVIDIAドライバーの導入方法についても不適切な説明をしました。
具体的には、NVIDIAドライバーを外部サイトから直接ダウンロードしてインストールするコマンドを生成しました。
しかし、そのコマンドには、一般的なx86-64パソコン向けではないアーキテクチャを示すパスが含まれていました。
このようなコマンドを、そのままターミナルで実行するのは危険です。
Linuxでは、AIが提示したコマンドによってシステムの設定が変更されることがあります。
特にドライバー、パーティション、ブートローダーなどに関するコマンドは、実行前に必ず確認する必要があります。
8. Qwen2.5 3B:非常に速いが文章が物足りない
次に試したのが、Qwen2.5の3Bモデルです。
このモデルは非常に軽量で、今回の環境では約80トークン/秒という速度が出ました。
ブログ記事の生成も約7.8秒で完了しました。
速度だけを見れば、今回試したモデルの中でも優秀です。
しかし、生成された文章は内容が薄く、詳しい解説には向いていないと感じました。
また、質問の意図を正しく理解できない場面もありました。
短い質問への回答や簡単な文章作成には使えそうですが、詳しいSEO記事を作成するには力不足という印象です。
9. Qwen2.5 7B:期待したほど品質が向上しなかった
続いて、Qwen2.5の7Bモデルを試しました。
3Bモデルより規模が大きいため、文章の品質向上を期待していました。
しかし、実際にブログ記事を書かせたところ、生成には42.7秒かかりました。
生成速度は約29.47トークン/秒です。
記事の内容も、期待したほど詳しくありませんでした。
容量偽装の仕組みについて一般的な説明はできていましたが、具体性が不足していました。
また、まとめが重複したり、指定した文字数に届かなかったりする問題もありました。
今回のパソコン環境では、Gemma 3 4Bより時間がかかる一方、文章の品質が明確に向上したとは感じられませんでした。
そのため、検証後にアンインストールしました。
10. Qwen2.5-Coder 7B:ブログ執筆には不向きだった
Qwen2.5-Coder 7Bも試してみました。
こちらはプログラミング用途を重視したモデルです。
実際に記事を書かせたところ、22.8秒で回答が生成されました。
生成速度は約29.66トークン/秒でした。
文章は生成できましたが、容量偽装の仕組みや確認方法についての説明は簡潔で、今回求めていた詳しいブログ記事にはなりませんでした。
プログラミング向けのモデルだからといって、ブログ記事の執筆にも優れているとは限らないことがわかりました。
11.Qwen3 4B:推論に時間がかかりすぎた
最後に紹介するのが、Qwen3の4Bモデルです。
Qwen3には、回答前に推論を行う仕組みがあります。
複雑な問題を解く場合には役立つ機能ですが、今回の環境では大きな問題になりました。
それが、回答までの待ち時間です。
実際に記事を書かせたところ、2分23秒かかりました。
画面には「Thought for 2m 1s」と表示されており、回答を作成する前の推論に約2分かかっていました。
推論を停止する設定もいろいろ試しましたが、期待した結果にはなりませんでした。
しかも、時間をかけて生成された記事にも技術的な間違いがありました。
今回の用途では、待ち時間に見合った品質が得られなかったという印象です。
無料AIモデルの速度を比較してみた
今回の検証結果を、モデルごとに整理してみました。
- Gemma 3 4B
- 応答時間:15.2〜24.8秒
- 生成速度:約57〜58トークン/秒
- 印象:比較的自然な日本語を生成できる
- Qwen2.5 3B
- 応答時間:7.8秒
- 生成速度:約80トークン/秒
- 印象:非常に速いが、内容が薄い
- Qwen2.5 7B
- 応答時間:42.7秒
- 生成速度:約29トークン/秒
- 印象:期待したほど詳しい文章にならなかった
- Qwen2.5-Coder 7B
- 応答時間:22.8秒
- 生成速度:約30トークン/秒
- 印象:文章は生成できるが、内容が簡潔
- Qwen3 4B(カスタム設定)
- 応答時間:2分23秒
- 生成速度:約48トークン/秒
- 印象:推論時間が長く、回答まで待たされる
※数値は私のパソコンで測定した結果です。記事の長さや設定が完全に同じではないため、厳密な性能比較ではありません。
今回の結果では、Gemma 3 4Bが比較的使いやすいと感じました。
一方、Qwen2.5 3Bは非常に高速ですが、ブログ記事の内容が薄くなりがちでした。
また、モデルの規模が大きければ、必ず文章の品質が向上するわけではないこともわかりました。
無料AIはブログ運営の補助として使えるのか?
今回、最も確認したかったのが、ローカルAIの文章生成能力です。
結論からいうと、無料のローカルAIでも文章を生成することはできますが、今回試したモデルではChatGPTの代わりとして利用するには課題が残りました。
実体験を正確に反映できないことがある
今回の検証では、実際に経験したmicroSDカードのトラブルを題材にしました。
ところが、AIが「カメラやゲーム機で使用した」「動画編集を始めようと思っていた」といった、伝えていない内容を追加することがありました。
実体験を題材にする場合、こうした内容が加わると事実関係が変わってしまいます。
そのため、生成された文章を確認し、実際の出来事と一致しているかを判断する必要があります。
技術的な間違いも発生する
もう一つ気になったのが、技術的な説明の正確性です。
例えば、容量偽装されたmicroSDカードについて、AIが「システムが自動的に動画を削除する」と説明したことがありました。
しかし、実際には記憶領域を超えた書き込みによって、データが破損したり、正常に読み出せなくなったりする場合があります。
また、フォーマット用のソフトウェアを、容量偽装を検出できるツールとして紹介したこともありました。
こうした説明の正確性は、AIをブログ運営の補助として使ううえでも重要です。
長い文章を生成するのが苦手なモデルもある
3,000〜5,000文字の記事を依頼しても、短い文章で終わってしまうことがありました。
プロンプトを変更しても、必ず改善するわけではありません。
今回の検証では、長い文章を一度に生成する能力についても、モデルごとに違いがあることがわかりました。
見出しごとに文章を生成させる方法など、今後試してみたい工夫もあります。
ブログの文章作成に特化したAIを使う方法もある
今回、OllamaとAnythingLLM、Open WebUIを使って複数のAIモデルを試してみましたが、文章の自然さや内容の正確さにはモデルごとに違いがありました。
特にブログの文章作成では、AIが生成した内容をそのまま信用せず、自分で確認することが重要だと感じました。
もし、ローカルAIの設定やパソコンの性能を気にせず、ブログの文章作成をサポートしてくれるAIを探しているなら、「ラクリン」というサービスもあります。
ラクリンはブログ記事の作成を支援するAIツールで、無料プランから試すことができます。
ローカルAIとは仕組みが異なりますが、文章作成を目的としている方なら、選択肢の一つになるでしょう。
▶ ラクリンの無料プランを確認してみる

ローカルAIを使って感じたメリット
AIの文章生成に利用料金がかからない
最大のメリットは、ローカル環境で実行する限り、文章を生成するたびにAPI利用料金が発生しないことです。
ブログ記事の構成を考えたり、文章の改善案を求めたりする場合でも、トークン数に応じた追加料金を気にする必要はありません。
もちろん、電気代やパソコンの購入費用などは別です。
自分のパソコンで動かせる
AIモデルをダウンロードしておけば、通常の文章生成をローカル環境で実行できます。
インターネット接続がなくても利用できる構成にできる点も魅力です。
ただし、モデルのダウンロードや外部検索機能などにはインターネット接続が必要です。
複数のモデルを自由に試せる
Ollamaでは、さまざまなモデルを切り替えて利用できます。
今回のように、実際に文章を書かせて比較できるのは便利です。
不要になったモデルは削除できるので、ストレージ容量を調整しながら利用できます。
ローカルAIのデメリット
パソコンの性能に左右される
ローカルAIは、パソコンの性能によって使い勝手が大きく変わります。
特にGPUのVRAM容量は重要です。
今回のGTX 1660 TiはVRAMが6GBなので、大きなモデルを快適に動かすには制約があります。
Qwen3の8Bモデルを試した際には、GPUだけで処理できず、生成速度が大きく低下しました。
高性能なAIモデルを快適に利用するには、より多くのVRAMを搭載したGPUが必要になる場合があります。
初期設定に手間がかかる
Ollamaのインストールだけでなく、AnythingLLMとの接続やモデルの設定なども必要です。
また、モデルによって適切なコンテキストウィンドウの設定が異なります。
今回も、コンテキストの設定や推論停止の調整に時間がかかりました。
ChatGPTのように、ブラウザを開いてすぐに利用できるサービスと比べると、導入の難易度は高めです。
情報の正確性は保証されない
ローカルAIも、間違った情報を生成することがあります。
特に、専門的な解説や最新情報を扱う場合は注意が必要です。
今回試したモデルでは、検索結果を自動的に確認して記事を書く仕組みまでは構築していません。
そのため、最新の製品情報や価格、仕様などは別途確認する必要があります。
ChatGPTと無料ローカルAIはどちらがおすすめ?
今回、複数のローカルAIモデルを試してみて、無料でも十分に文章を生成できることがわかりました。
特にGemma 3 4Bは、私のパソコンでも比較的快適に動作し、日本語の文章も自然でした。
しかし、その後の追加検証では、Linux MintやLMDEに関する基本的な質問に間違った回答をすることがあり、技術情報の正確性に課題があることもわかりました。
そこで、Gemma 3以外にもQwen、DeepSeek、Llama、Phi、Granite、Ministral、Ayaなど、さまざまなモデルを試しました。
その結果、回答速度が速いモデルでも技術情報を間違えることがあり、反対に、回答まで数分かかるモデルでも正確な情報を得られるとは限らないことがわかりました。
中でも印象的だったのが、Aya Expanse 8Bです。
Linux MintのNVIDIAドライバー導入方法を質問したところ、不適切なダウンロード先を含むコマンドを生成しました。
このような回答をそのまま信用して実行すると、システムに問題が発生する可能性もあります。
一方、Qwen3.5 4Bは、今回試したモデルの中では比較的実用的な文章を生成できる印象でした。
ただし、長文の記事では誤情報が混入することもあり、技術的な説明をそのまま信用できるわけではありません。
今回の検証を通じて感じたのは、ローカルAIの性能を判断するうえで、回答速度や文章の自然さだけでは不十分だということです。
ブログ記事の作成では、実体験を正確に反映できるか、技術的な説明に誤りがないか、必要な情報を整理できるかといった点も重要になります。
そのため、少なくとも今回の私のパソコン環境では、無料のローカルAIだけでChatGPTを完全に置き換えるのは難しいと感じました。
ただし、記事構成の作成や文章の言い換え、簡単な質問への回答など、補助的な用途であれば十分に活用できる可能性があります。
今後は、AIモデルを変更するだけでなく、公式ドキュメントなどの資料を参照させる方法も試してみたいと考えています。
ローカルAIは、ChatGPTの完全な代替としてではなく、用途に応じて使い分けるのが現実的だと思います。
導入の手軽さ
ChatGPTは、ブラウザからアクセスするだけで利用できます。
一方、ローカルAIではOllamaのインストールやモデルのダウンロード、AnythingLLMとの接続設定などが必要です。
初心者にとっては、ChatGPTの方が手軽に始められるでしょう。
利用料金
ChatGPTの料金は、利用するプランや機能によって異なります。
一方、ローカルAIは外部の有料APIを使わなければ、文章生成のたびに料金が発生することはありません。
ただし、パソコンの購入費用や電気代などは必要です。
文章生成能力
ChatGPTでは、高性能なAIモデルを利用できます。
今回試したローカルAIでも文章を生成できましたが、内容の詳しさや正確性にはモデルごとに違いがありました。
特に、長い文章を作成する場合には、指定した文字数に届かないこともありました。
最新情報への対応
ChatGPTでは、検索機能を使って最新情報を確認できます。
一方、今回構築したローカルAI環境では、Web検索と連携して情報を確認する仕組みまでは導入していません。
そのため、最新の製品情報やソフトウェアの仕様などは、別途調べる必要があります。
インターネット接続
ChatGPTを利用するには、基本的にインターネット接続が必要です。
一方、ローカルAIは必要なモデルをダウンロードしておけば、オフラインでも文章を生成できます。
この点は、ローカルAIならではのメリットです。
今回の検証結果だけで、すべてのローカルAIがChatGPTより劣っているとはいえません。
より高性能なパソコンや別のAIモデルを使用すれば、結果が変わる可能性もあります。
ただし、少なくとも私の環境では、現時点でChatGPTを完全に置き換えるのは難しいと感じました。
まとめ:無料ローカルAIへの完全移行は難しいが、使い分ける価値はある
今回は、ChatGPTの料金体系や利用条件への関心をきっかけに、無料で利用できるローカルAIを実際に試してみました。
OllamaとAnythingLLM、Open WebUIを組み合わせることで、自分のパソコンでもChatGPTに近い感覚でAIを利用できることがわかりました。
Gemma 3、Qwen、DeepSeek、Llama、Phi、Granite、Ministral、Ayaなど、さまざまなモデルを試した結果、回答速度や文章の自然さには大きな違いがありました。
特にGemma 3 4Bは動作が軽快で、日本語の文章も自然でした。一方、Qwen3.5 4Bは比較的実用的な文章を生成できる印象でした。
しかし、どのモデルでも技術的な誤情報が発生する可能性があり、回答が速いモデルや規模の大きなモデルが必ずしも正確とは限らないことを実感しました。
今回の検証では、Linux MintやLMDEの基本情報を間違えるだけでなく、不適切なコマンドを生成するモデルもありました。
そのため、Linuxの操作方法やパソコンのトラブル解決など、技術的な情報を扱う場合には、AIの回答をそのまま信用せず、自分で確認することが重要です。
現時点では、私のパソコン環境でChatGPTを完全に置き換えるのは難しいと感じています。
それでも、ブログ記事の構成作成や文章の言い換えなど、補助的な用途では十分に活用できる可能性があります。
今後は、AIモデルを変更するだけでなく、公式資料を参照させる方法なども試しながら、ローカルAIの可能性を探っていきたいと思います。
ローカルAI以外の無料AIも試してみたい方へ
今回の検証では、無料のローカルAIにも魅力がある一方で、ChatGPTの代わりとして使うには、まだ難しい部分があると感じました。
ただ、AIにはさまざまな種類があり、用途によって向いているサービスも異なります。
ブログの文章作成を中心にAIを活用したいなら、記事作成に特化した「ラクリン」も選択肢の一つです。
無料プランでは毎月20,000トークンを利用でき、クレジットカードの登録も必要ありません。
まずは無料で試して、自分の用途に合っているか確認してみてはいかがでしょうか。
▶ ラクリンを無料で試してみる
メルマガはこちら
↓ ↓ ↓